افحص ما بداخل Gemma 3 على TPU مجانية
تم النشر:
استخراج التفعيلات بـ JAX وKeras، وما تكشفه عن العربية والإنجليزية
تبدو النماذج اللغوية صندوقاً أسود: يدخل نص ويخرج نص، وما بينهما نسمّيه “النموذج”. لكن ما بينهما ليس إلا أرقاماً يمكن قراءتها. كل طبقة في النموذج تسلّم الطبقة التالية متجهاً من الأرقام، وهذه المتجهات، أي التفعيلات (activations)، هي المكان الذي يحدث فيه عمل النموذج فعلاً.
في مقالي الأول عن TPU ذكرت سبعة أسباب لتجربتها. أما هذا المقال فعملي. على شريحة TPU v5e واحدة مجانية في Google Colab سنقوم بما يلي:
- نستخرج الحالة الداخلية بعد كل طبقة من طبقات Gemma 3 1B الست والعشرين، بدالة JAX واحدة مُترجمة.
- نستخدم عدسة اللوجِت (logit lens) لنشاهد الإجابة وهي تتكوّن طبقة بعد طبقة.
- نبحث أين يفصل Gemma بين العربية والإنجليزية، وأين يدرك أن جملتين تحملان المعنى نفسه.
- نوجّه النموذج بمتجه واحد، فيجيب عن سؤال إنجليزي بالعربية.
كل رقم ورسم في هذا المقال من تشغيل فعلي للدفتر المرافق. افتح الدفتر وأعد التجربة كاملة مجاناً.
لماذا ننظر داخل النموذج؟
في الغالب نحكم على النموذج من إجاباته. وهذا يخبرنا ماذا يفعل، لا كيف. أما قابلية التفسير (interpretability) فتسأل: كيف؟ أي الطبقات تحمل أي معلومة، وماذا يتغير إذا حرّكناها؟ وهي أيضاً أداة من أدوات الأمان. ففي مقال سابق استخدمتها لإيجاد الاتجاه الواحد الذي يتحكم في الرفض داخل Gemma 3. والطريقة هنا من العائلة نفسها، لكن على موضوع ألطف: اللغة.
التجهيز: TPU مجانية في دقيقتين
في Colab اختر Runtime ← Change runtime type ← v5e-1 TPU. وافق على رخصة Gemma في Hugging Face، ثم أضف مفتاحك من Hugging Face في 🔑 Secrets باسم HF_TOKEN. (يعمل الدفتر أيضاً على Kaggle، ويحمّل الأوزان نفسها من Kaggle Models.)
نستخدم Keras 3 فوق JAX. فـ JAX هو الإطار الذي صُممت TPU حوله، ومكتبة KerasHub توفّر Gemma 3 جاهزاً للتحميل:
import os
os.environ["KERAS_BACKEND"] = "jax"
import keras_hub

causal_lm = keras_hub.models.Gemma3CausalLM.from_preset(
    "hf://google/gemma-3-1b-it", dtype="bfloat16")
backbone = causal_lm.backbone
tokenizer = causal_lm.preprocessor.tokenizer
صيغة bfloat16 هي صيغة الأرقام التي بُنيت TPU حولها. للنموذج 26 طبقة، وحجم حالته الداخلية 1,152، ولم يستهلك إلا 7.5 جيجابايت من أصل 50 جيجابايت من ذاكرة الجلسة.
الخطوة الأولى: تفعيلات كل الطبقات
النموذج في جوهره مجموعة طبقات مكدّسة. نعيد بناء مساره الأمامي كنموذج Keras وظيفي يُرجع مخرجات كل طبقة. وهو يعيد استخدام الطبقات الأصلية نفسها، فالأوزان مشتركة ولا يُنسخ شيء:
token_ids = keras.Input(shape=(None,), dtype="int32")
padding_mask = keras.Input(shape=(None,), dtype="int32")

x = backbone.token_embedding(token_ids)
x = x * keras.ops.cast(keras.ops.sqrt(backbone.hidden_dim), x.dtype)
hidden_states = []
for block in backbone.transformer_layers:
    x = block(x, padding_mask=padding_mask)
    hidden_states.append(x)

extractor = keras.Model([token_ids, padding_mask], hidden_states)
وقبل أن نثق به، يتحقق الدفتر أن مخرجات آخر طبقة، بعد التطبيع النهائي، تطابق النموذج الأصلي تماماً. وقد تطابقت.
السرعة: دالة واحدة مُترجمة
الدالة stateless_call تحوّل نموذج Keras إلى دالة نقية مدخلاتها (الأوزان، البيانات)، وهذا بالضبط ما تحتاجه jax.jit:
@jax.jit
def activations(weights, ids, mask):
    outs, _ = extractor.stateless_call(weights[0], weights[1], [ids, mask])
    h = jnp.stack(outs, axis=1).astype(jnp.float32)   # (batch, layers, seq, hidden)
    ...                                               # pool on the TPU, return small arrays
تفصيلتان تصنعان فرقاً كبيراً:
- التجميع على الشريحة نفسها. لا نُرجع المصفوفة الكاملة، بل حالة آخر كلمة في كل جملة ومتوسطها على كلماتها فقط. فتنتقل بيانات أقل من الشريحة إلى الجهاز المضيف.
- جاهزة للتوزيع. يضع الدفتر الأوزان والبيانات على
jax.sharding.Mesh. على شريحة واحدة يعمل كما هو، وعلى TPU بثماني أنوية (في Kaggle) ينسخ الكود نفسه الأوزان ويوزّع الدفعة على الأنوية.
هذا ما كلّفه تمرير 64 جملة عبر الطبقات الست والعشرين كلها:
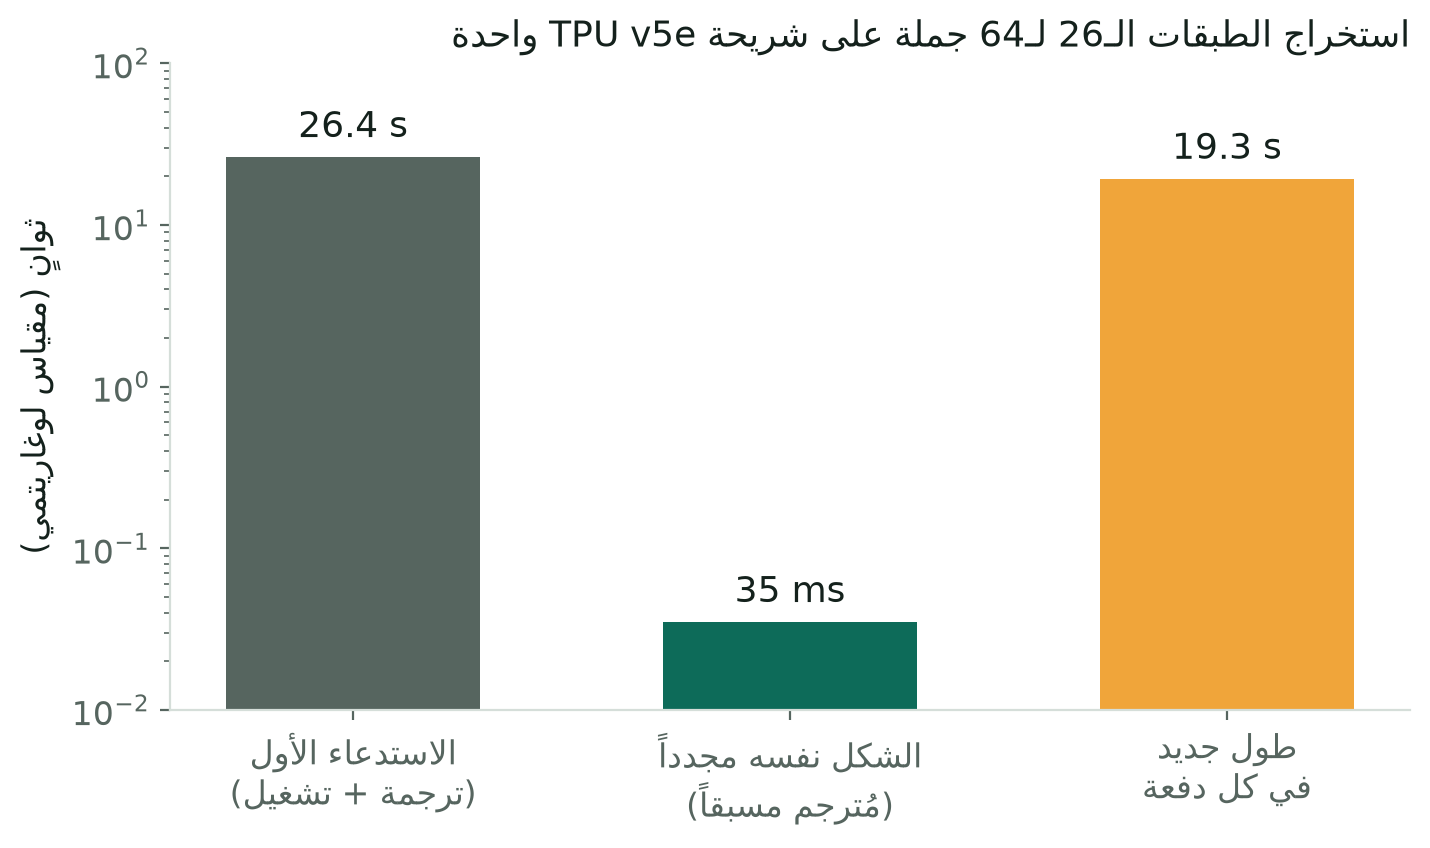
الاستدعاء الأول أخذ 26.4 ثانية، وأغلبها في ترجمة XLA للبرنامج. بعدها صار الاستدعاء نفسه يأخذ 35 جزءاً من الألف من الثانية، أي أسرع بنحو 750 مرة.
أما العمود البرتقالي فهو الفخ. إذا تغيّر طول المدخلات في كل دفعة، يعيد JAX الترجمة في كل مرة: 19.3 ثانية لكل دفعة. على TPU ثبات الأشكال هو كل شيء. احشُ مدخلاتك (padding) إلى طول ثابت، فتُترجم مرة واحدة فقط.
الخطوة الثانية: عدسة اللوجِت
آخر طبقة تحوّل الحالة الداخلية إلى توقّع: تطبيع نهائي، ثم ضرب في مصفوفة التضمين. عدسة اللوجِت (nostalgebraist، 2020) تطبّق القراءة نفسها على كل طبقة وسيطة، كأننا نطلب من النموذج أن يجيب مبكراً:
@jax.jit
def lens(h):   # h: (layers, hidden)
    logits = backbone.token_embedding(backbone.layer_norm(h), reverse=True)
    return jax.nn.softmax(logits, axis=-1)
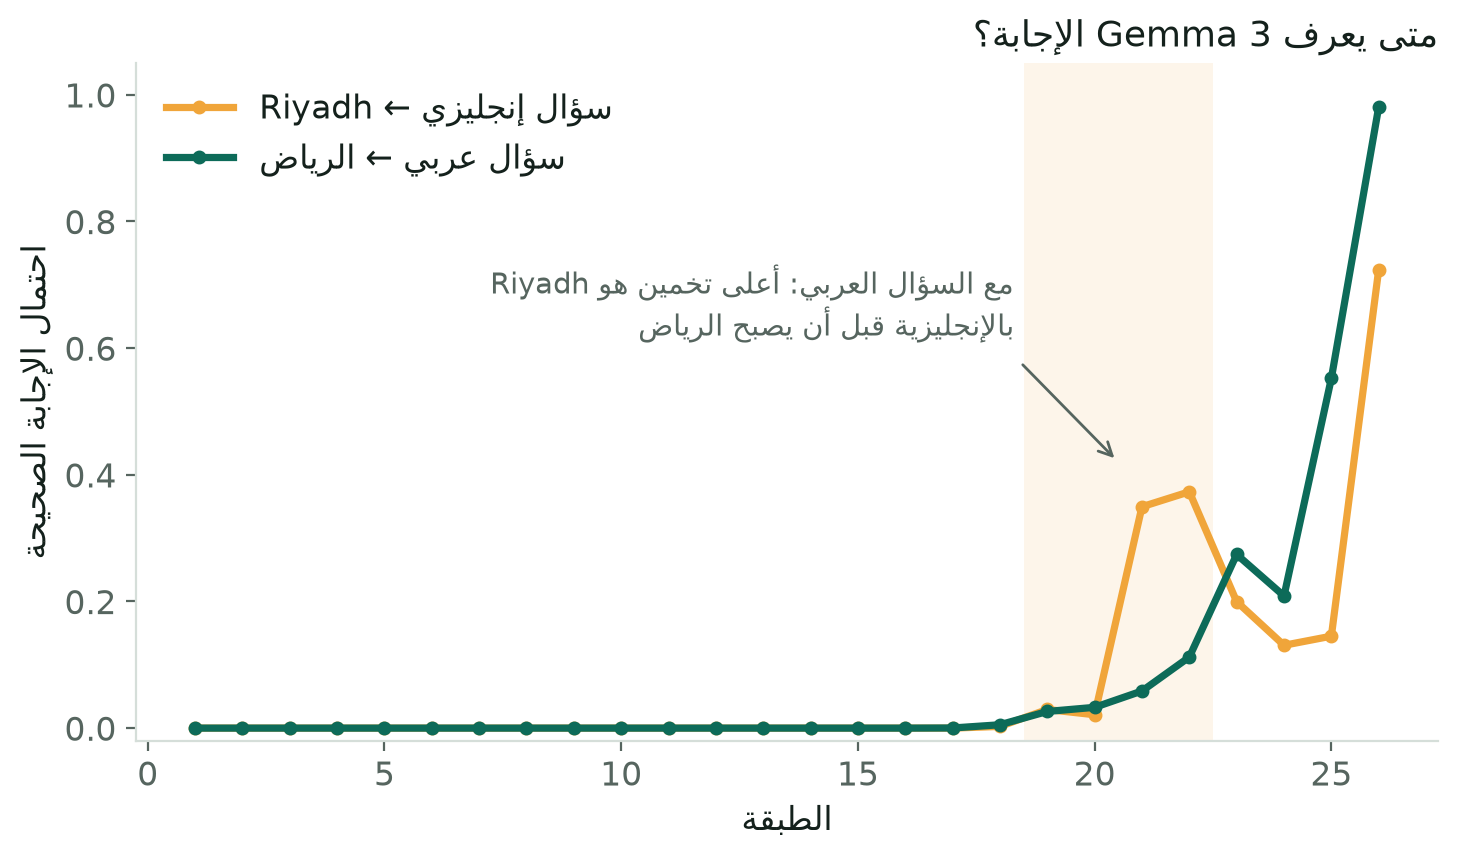
طرحت السؤال نفسه باللغتين: “The capital of Saudi Arabia is” و“عاصمة المملكة العربية السعودية هي”.
ثلاثة أشياء تلفت النظر:
- لا إجابة إطلاقاً في أول 17 طبقة. احتمال الإجابة الصحيحة يبقى قريباً من الصفر حتى الطبقة 18. الطبقات الأولى مشغولة بشيء آخر.
- بالإنجليزية، تأتي “Washington” أولاً. في الطبقة 20 أعلى تخمين هو Washington، أي “عاصمة” عامة قبل العاصمة المقصودة. وفي الطبقة التالية يتحول إلى Riyadh ولا يتركها، وينتهي باحتمال 72%.
- بالعربية، يمرّ النموذج بالإنجليزية. من الطبقة 19 إلى 22 كان أعلى تخمين للسؤال العربي هو الكلمة الإنجليزية “Riyadh”. ولم تصبح “الرياض” إلا في الطبقة 23، وانتهى بها باحتمال 98%.
هذا النمط الأخير يتفق مع أبحاث على نموذج Llama-2 (Wendler وآخرون، 2024) تشير إلى أن النماذج متعددة اللغات تعمل في طبقاتها الوسطى عبر فضاء قريب من الإنجليزية. سؤال واحد لا يكفي دليلاً، لكنه مشهد لافت حين تراه على شاشتك.
الخطوة الثالثة: اتجاه للغة
بعد ذلك أخذت 40 جملة قصيرة من الحياة اليومية، كل واحدة بالعربية وبالإنجليزية: “تشرق الشمس من الشرق.” / “The sun rises in the east.” لكل جملة نأخذ متوسط تفعيلاتها على كلماتها، في كل طبقة. ثم نطرح سؤالين:
- هل يكفي اتجاه واحد للتمييز بين اللغتين؟ نحسب الفرق بين متوسط التفعيلات العربية ومتوسط الإنجليزية على نصف الأزواج، ثم نختبره على النصف الآخر.
- هل يعرف النموذج أن الجملتين تحملان المعنى نفسه؟ نطرح متوسط كل لغة، ثم نتحقق هل كل جملة عربية أقرب ما تكون إلى ترجمتها هي من بين الأربعين. الصدفة هنا 2.5%.
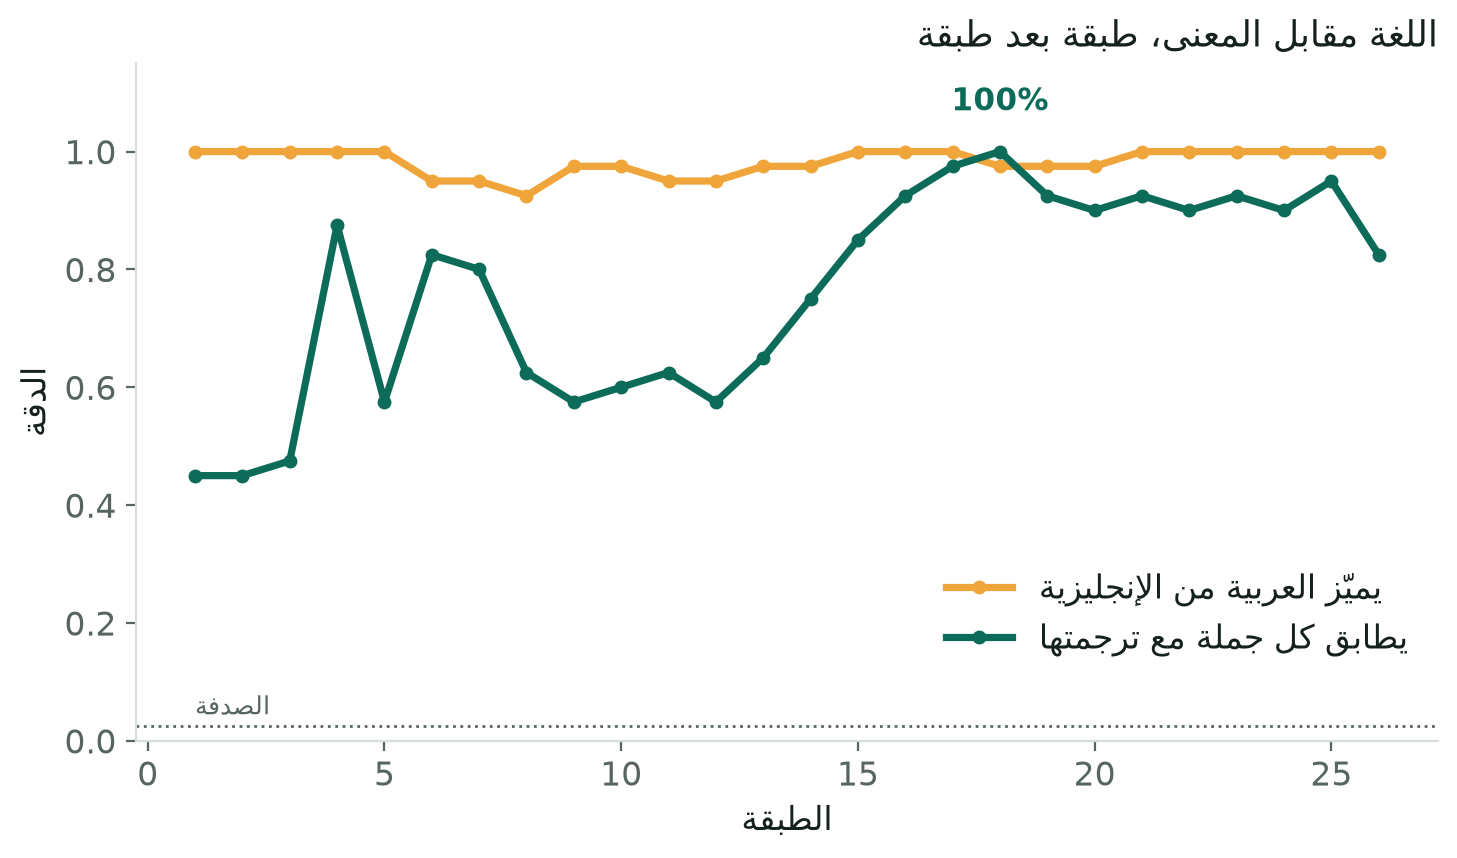
- اللغة ظاهرة دائماً. اتجاه واحد يفصل العربية عن الإنجليزية بدقة لا تقل عن 92.5% في كل الطبقات على جمل لم يرها. النموذج لا ينسى أبداً بأي لغة يقرأ.
- المعنى يتقارب ثم يبلغ ذروته في الطبقة 18. مطابقة الترجمات تبدأ عند 45% في الطبقة الأولى، وتصعد إلى 100% في الطبقة 18. في هذه الطبقة، كل جملة عربية هي الأقرب إلى ترجمتها الإنجليزية.
ويمكن رؤية الأمرين معاً في إسقاط ثنائي الأبعاد:
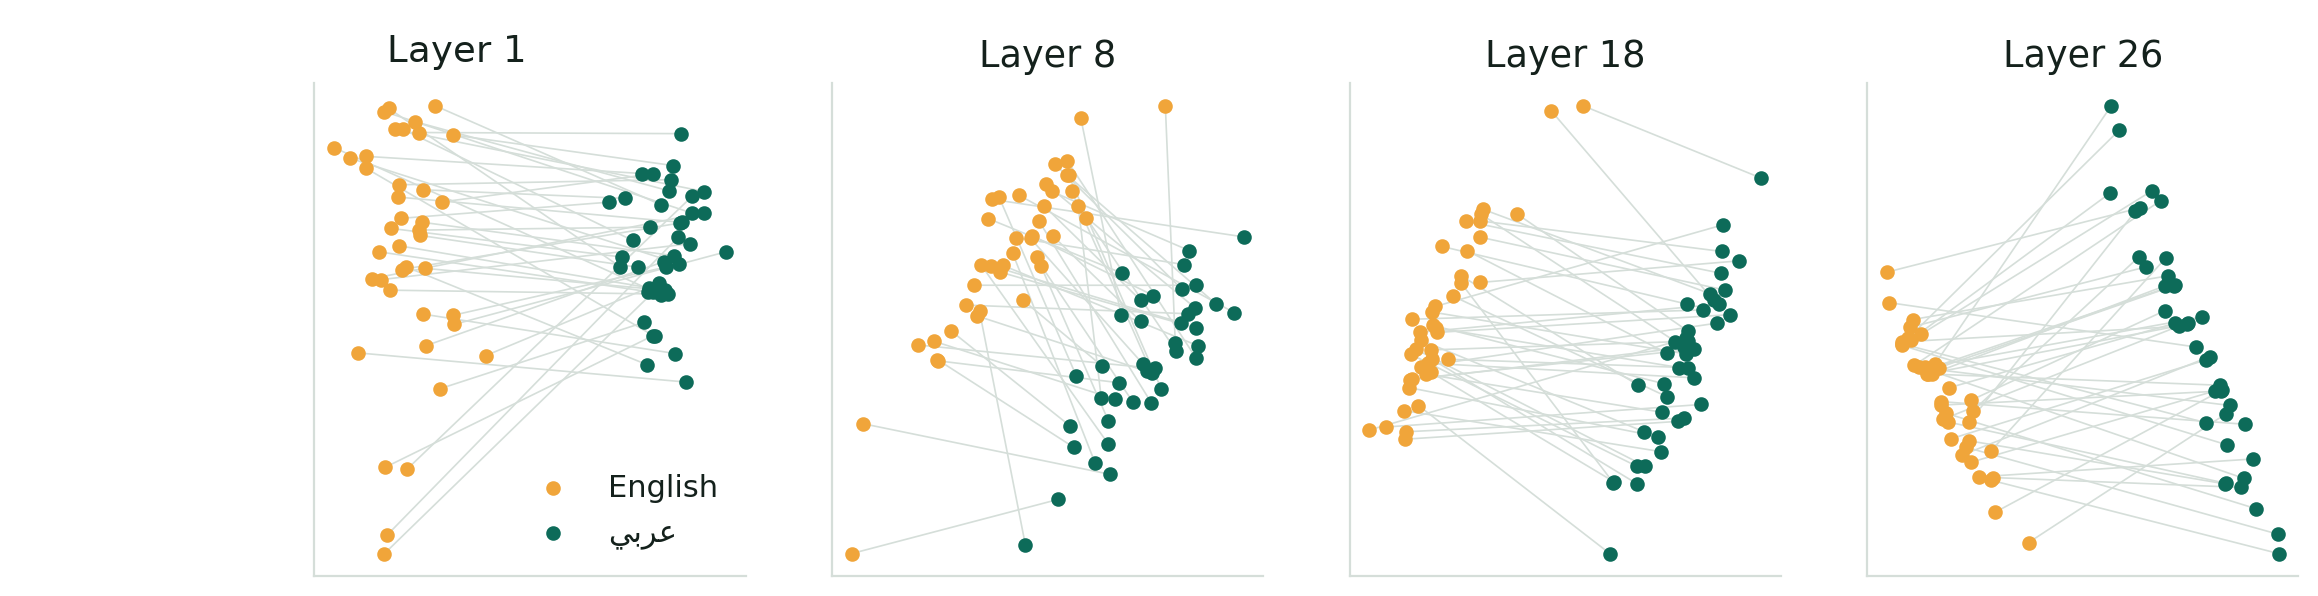
تبقى اللغتان على جانبين متقابلين في كل الرسوم، وهذا هو اتجاه اللغة. لكن في الطبقة 18 تصبح الخطوط الرمادية التي تصل كل جملة بترجمتها أكثر توازياً بكثير منها في الطبقتين 1 و8. المعنى نفسه يقع على الارتفاع نفسه في الجانبين، والمسافة بين اللغتين خطوة واحدة مشتركة.
الخطوة الرابعة: التوجيه بمتجه واحد
إذا كانت اللغة اتجاهاً، فيمكننا الدفع على امتداده. نعيد بناء النموذج مرة أخرى بمدخل ثالث: متجه يُضاف إلى الحالة الداخلية بعد الطبقة 18. هذا المتجه هو الفرق بين متوسط العربية ومتوسط الإنجليزية، مضروباً في قوة c.
for i, block in enumerate(backbone.transformer_layers):
    y = block(y, padding_mask=m_in)
    if i == STEER_LAYER:
        y = y + keras.ops.expand_dims(steer_input, 1)
كل صف في الدفعة يمكن أن يحمل متجهه الخاص، فنجرّب عدة قوى في استدعاء واحد. والسؤال بالإنجليزية: “Write one short sentence about the ocean.” (اكتب جملة قصيرة عن المحيط).
القوة c | إجابة Gemma 3 |
|---|---|
| 0 (بلا توجيه) | The ocean is a vast and powerful expanse of water covering over 70% of the Earth. (المحيط مساحة مائية شاسعة وقوية تغطي أكثر من 70% من الأرض.) |
| 0.5 | The ocean is a vast and mysterious realm teeming with life. (المحيط عالم شاسع وغامض يعجّ بالحياة.) |
| 1.0 | المرج هو عالم البحار، مليئًا بالمعلومات والأسرار. |
| 1.5 | عربية مكسّرة تختلط فيها حروف لغات أخرى |
| 2.0 | عربية مكسّرة |
| 3.0 فأكثر | مقاطع مكررة (…حةحةحةحة) |
عند c = 1.0 أجاب النموذج عن سؤال إنجليزي بالعربية، وبقي في الموضوع نفسه: “عالم البحار المليء بالمعلومات والأسرار”. عربيته ليست كاملة، فقد بدأ بكلمة المرج بدل البحر، وفيها خطأ نحوي. وإذا زدنا القوة انهار النص. للتوجيه نقطة مثلى: القليل لا يفعل شيئاً، والكثير يكسر النموذج. وهذه هي فكرة “إضافة التفعيلات” (Turner وآخرون، 2023) نفسها، وجدناها هنا بأربعين زوجاً من الجمل ودون أي تدريب.
دروس لتجارب قابلية التفسير على TPU
- ثبّت الأشكال. طول جديد للمدخلات يعني ترجمة جديدة، وكان الفرق هنا 19 ثانية مقابل 35 جزءاً من الألف من الثانية.
- اختصر البيانات على الشريحة. اجمع أو اقتطع داخل دالة
jit، وأرسل مصفوفات صغيرة فقط. stateless_callمعjax.jitهما الجسر من نموذج Keras إلى JAX نقي قابل للترجمة.- توقّع تحذيراً عن flash attention. على TPU تجرّب Keras أولاً نواة الانتباه Splash، وهي تحتاج أطوالاً من مضاعفات 128. مع المدخلات الأقصر تكتب رسالة خطأ وتعود تلقائياً إلى الانتباه العادي. النتيجة واحدة، والدفتر يخفي هذه الرسائل.
- راقب ذاكرة الجهاز المضيف، لا ذاكرة TPU فقط. محاولتي الأولى توقفت لامتلاء ذاكرة الجلسة أثناء التحميل. أما النسخة النهائية، التي حذفت منها تجربة
generate()، فلم تتجاوز 7.5 جيجابايت.
ماذا فعلنا؟
بشريحة TPU مجانية واحدة ونحو مئة سطر من Keras وJAX، قرأنا الطبقات الست والعشرين لنموذج Gemma 3. رأينا الإجابة لا تظهر إلا في الثلث الأخير من الشبكة، وغالباً بالإنجليزية أولاً. ووجدنا اتجاهاً يفصل بين اللغتين، وطبقة تتطابق فيها معانيهما. ثم استخدمنا ذلك الاتجاه لنغيّر لغة الإجابة.
جرّبه بنفسك: افتح الدفتر، واستبدل أزواج الجمل بمفهوم آخر (رسمي مقابل عامّي، أو إيجابي مقابل سلبي)، أو جرّب نموذج 4B على TPU أكبر.
جزء من سلسلة قصيرة عن TPU. المقال السابق: 7 أسباب للانتقال إلى وحدات TPU.
المراجع
- nostalgebraist (2020). Interpreting GPT: the logit lens.
- Wendler, C., Veselovsky, V., Monea, G., & West, R. (2024). Do Llamas Work in English? On the Latent Language of Multilingual Transformers.
- Turner, A. M., et al. (2023). Steering Language Models With Activation Engineering.
- Arditi, A., et al. (2024). Refusal in Language Models Is Mediated by a Single Direction.