استكشاف اتجاه الرفض في نماذج Gemma 3 على TPU
تم النشر:
امتداد لورقة “Refusal in Language Models Is Mediated by a Single Direction”
تطبيق المنهج الأصلي على عائلة Gemma 3 الجديدة من Google، مع تسريع التجارب باستخدام وحدات معالجة الموترات (TPU)
الورقة الأصلية: arXiv:2406.11717 الكود: GitHub — andyrdt/refusal_direction التدوينة الأصلية: LessWrong
نسختي المعدّلة: Ruqyai/refusal_direction
لماذا يهم هذا البحث
في أبريل 2024 نشر Andy Arditi وفريقه من برنامج MATS دراسة رائدة كشفت نتيجة لافتة: سلوك الرفض في النماذج اللغوية الكبيرة يتحكم فيه اتجاه واحد في فضاء التمثيلات الداخلية. أي أن كل الردود المتنوعة التي نراها عندما يرفض النموذج طلباً ضاراً، من “عذراً، لا أستطيع المساعدة في ذلك” إلى “هذا الطلب غير مناسب”، تمر كلها عبر عنق زجاجة واحد داخل الشبكة العصبية.
الورقة الأصلية “Refusal in Language Models Is Mediated by a Single Direction”، تأليف Andy Arditi وOscar Obeso وAaquib Syed وDaniel Paleka وNina Panickssery وWes Gurnee وNeel Nanda. نُشرت ضمن برنامج ML Alignment & Theory Scholars (MATS) بإشراف Neel Nanda وWes Gurnee.
أهم نتائج البحث الأصلي
أثبت الباحثون أنه بعملية حسابية بسيطة، هي الفرق بين متوسط التفعيلات على التعليمات الضارة ومتوسطها على التعليمات غير الضارة، يمكن استخراج “اتجاه الرفض” من أي نموذج لغوي. وعند إزالة هذا الاتجاه، وهي عملية تسمى الاستئصال (ablation)، يفقد النموذج قدرته على الرفض تماماً. والعكس صحيح أيضاً: عند حقن هذا الاتجاه في تعليمات غير ضارة، يبدأ النموذج برفضها كأنها ضارة.
وثبتت هذه الظاهرة في عدة عائلات من النماذج منها Llama 2 وLlama 3 وGemma وQwen وYi، وبأحجام مختلفة. وهذا يدل على أن آلية الرفض خاصية عامة وليست سمة لنموذج بعينه.
ومعادلة الاستئصال بسيطة:
c'_out ← c_out − (c_out · r̂) r̂
حيث r̂ هو اتجاه الرفض بعد توحيد طوله، وc_out هو مخرج أي مكوّن يكتب في المسار المتبقي (residual stream).
القيمة العلمية والعملية
لهذا البحث قيمة مزدوجة. فمن الناحية العلمية، يقدّم دليلاً قوياً على أن النماذج اللغوية تستخدم تمثيلات خطية لترميز مفاهيم معقدة مثل “يجب أن أرفض”. وهذا يدعم فرضية التمثيل الخطي في مجال قابلية التفسير الآلي (mechanistic interpretability)، ويفتح الباب لفهم أعمق لطريقة عمل هذه النماذج من الداخل.
ومن الناحية العملية، يكشف البحث هشاشة آليات الأمان في النماذج مفتوحة المصدر. فبدلاً من الحاجة إلى ضبط دقيق مكلف أو هجمات معقدة، يمكن تجاوز ضوابط الأمان بتعديل بسيط في الأوزان. وهذا لا يمثل خطراً جديداً بحد ذاته، إذ كان معروفاً أن ضوابط الأمان يمكن إزالتها بالضبط الدقيق، لكنه يؤكد الحاجة إلى مناهج أمان أعمق وأكثر متانة.
لماذا عائلة Gemma 3؟
درس البحث الأصلي نموذج Gemma 2B-IT من الجيل الأول وأكد وجود اتجاه الرفض فيه. لكن عائلة Gemma 3 تمثل قفزة كبيرة في البنية تستحق دراسة مستقلة. فالإصدار الجديد (مارس 2025) يقدم عدة تحسينات جوهرية تدفعنا للسؤال: هل تنطبق الظاهرة نفسها عليه؟
ما الجديد في Gemma 3؟
يختلف Gemma 3-1B-IT عن سابقه في عدة جوانب رئيسية. أولاً، يستخدم بنية هجينة لطبقات الانتباه الذاتي تتناوب بين نوافذ انزلاقية محلية وانتباه شامل، بنسبة 5 طبقات محلية لكل طبقة شاملة. ثانياً، يدعم سياقاً بطول 128 ألف رمز (token)، وهي زيادة ضخمة مقارنة بالجيل السابق. ثالثاً، دُرّب باستخدام تقطير المعرفة (knowledge distillation) والتعلم المعزز، وقد يؤثر ذلك في طريقة ترميز سلوك الرفض.
فرضية البحث نتوقع أن يظل اتجاه الرفض موجوداً في Gemma 3-1B-IT نظراً لعمومية الظاهرة عبر البنى المختلفة. لكن بنية الانتباه الهجينة قد تؤثر في الطبقة التي يظهر فيها الاتجاه بأقوى صوره. وقد يكون الاتجاه أوضح أو أكثر تشتتاً نتيجة لتقنيات التدريب الجديدة.
خط التجربة
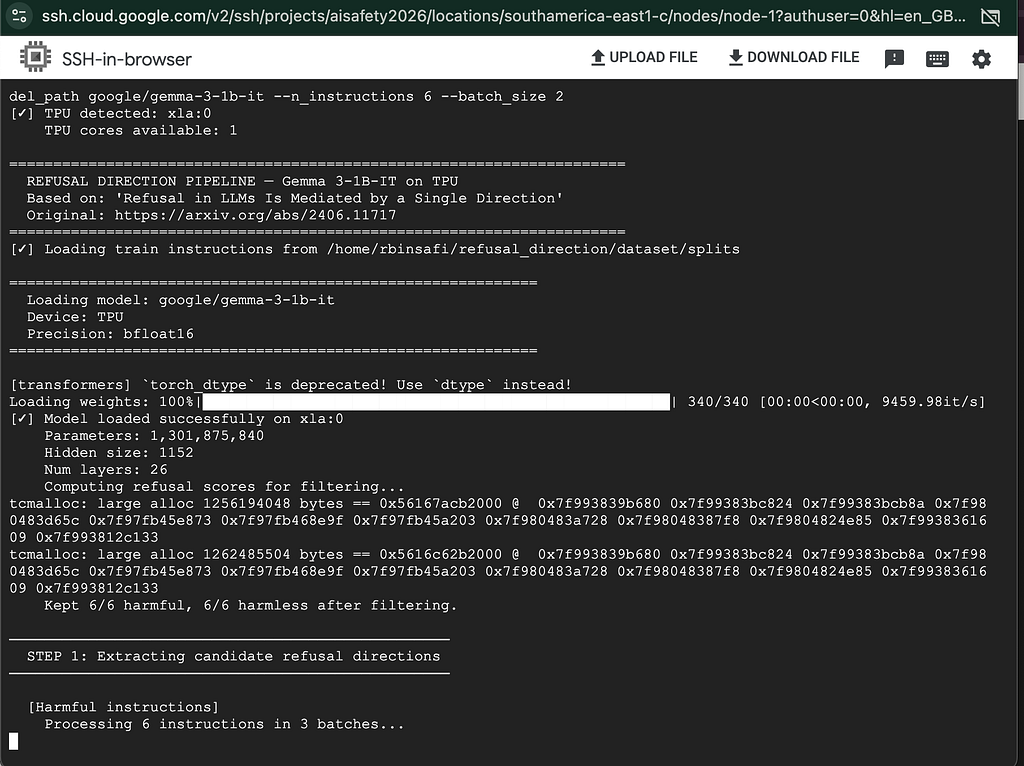
يتبع خط التجربة الخطوات الخمس نفسها من البحث الأصلي، مع تعديلات لدعم TPU وبنية Gemma 3.
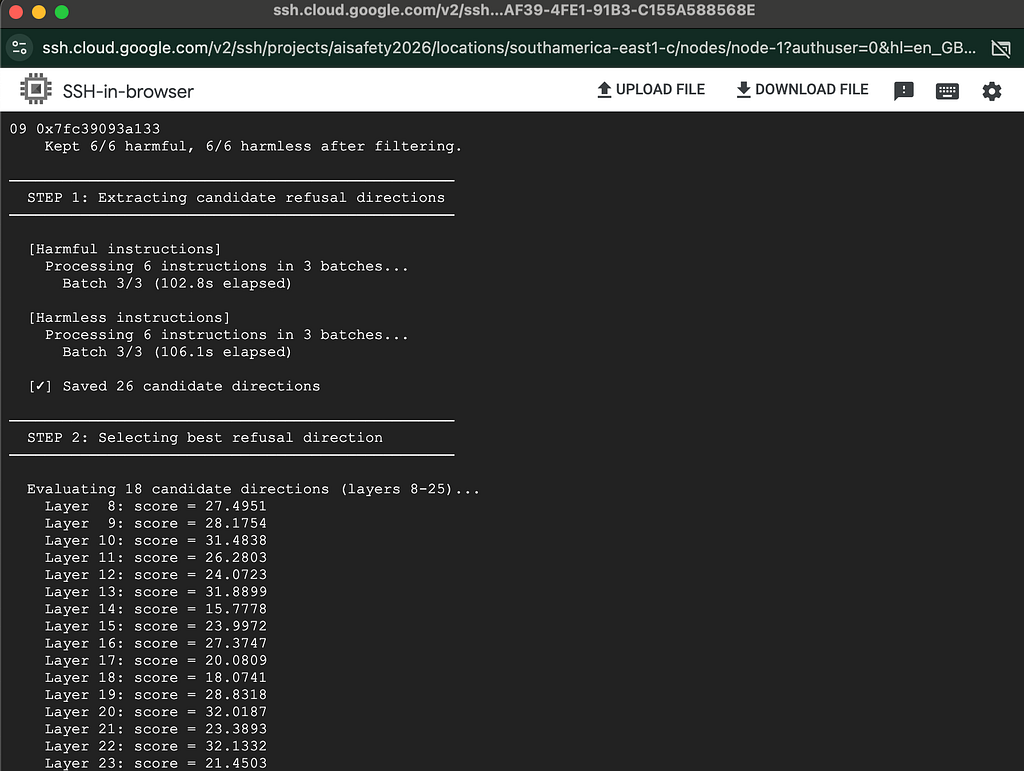
الخطوة 1: استخراج الاتجاهات المرشحة للرفض حساب الفرق بين متوسطات التفعيلات الضارة وغير الضارة في كل طبقة.
الخطوة 2: اختيار أفضل اتجاه للرفض تقييم كل اتجاه مرشح على مجموعة تحقق لاختيار الأكثر فعالية.
الخطوة 3: تقييم تجاوز الرفض إزالة الاتجاه وقياس انخفاض نسبة الرفض على التعليمات الضارة.
الخطوة 4: تقييم الرفض المستحث حقن الاتجاه في التعليمات غير الضارة وقياس ارتفاع نسبة الرفض.
الخطوة 5: تقييم الأثر على خسارة الإنتروبيا المتقاطعة (CE Loss) قياس مدى تأثير الاستئصال في القدرات اللغوية العامة للنموذج.
الإعداد والتشغيل
# 1. Clone the original repository
git clone https://github.com/Ruqyai/refusal_direction.git
cd refusal_direction

# 2. Install requirements + TPU support
pip install -r requirements.txt
pip install torch_xla cloud-tpu-client

# 3. Run the modified pipeline for Gemma 3
export HF_TOKEN="your_huggingface_token"
python refusal_direction_gemma3_tpu.py \
    --model_path google/gemma-3-1b-it \
    --n_instructions 256 \
    --batch_size 8
أهم التعديلات على الكود الأصلي
احتاج الكود الأصلي إلى عدة تعديلات ليعمل مع Gemma 3 على TPU. أولاً، استُبدلت استدعاءات torch.cuda بما يقابلها في torch_xla، مع إضافة نقاط مزامنة (xm.mark_step()) في المواضع المناسبة لضمان تنفيذ فعّال على TPU. ثانياً، حُدّث قالب المحادثة ليستخدم الصيغة الخاصة بـ Gemma 3 (<start_of_turn>). ثالثاً، اختير bfloat16 كنوع البيانات الافتراضي لأنه مدعوم بشكل أصلي على TPU ويعطي أداءً أفضل من float16.
# Automatic TPU detection with GPU/CPU fallback
import torch_xla.core.xla_model as xm
DEVICE = xm.xla_device()

# Load model in bfloat16 (native on TPU)
model = AutoModelForCausalLM.from_pretrained(
    "google/gemma-3-1b-it",
    torch_dtype=torch.bfloat16,
    device_map=None,
).to(DEVICE)

# TPU synchronization after batches
if TPU_AVAILABLE:
    xm.mark_step()
تسريع تجارب قابلية التفسير باستخدام TPU
اخترتُ ورقة “Refusal in Language Models Is Mediated by a Single Direction” (Arditi وآخرون، 2024) أساساً للتجربة، وطبقتها على Gemma 3-1B-IT، أحدث عائلة نماذج مفتوحة الأوزان من Google.
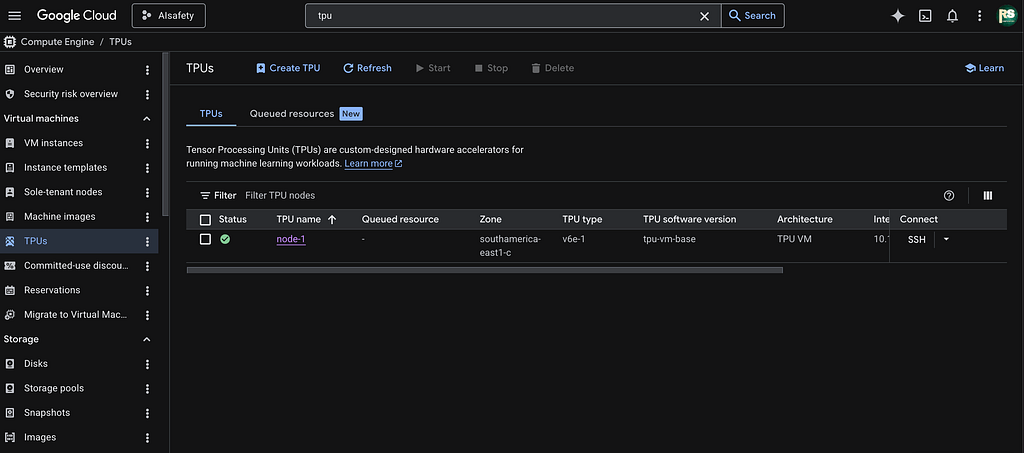
تحتاج تجارب قابلية التفسير الآلي إلى قدر كبير من الحوسبة. فاستخراج التفعيلات من مئات التعليمات عبر كل طبقات النموذج، ثم تقييم عشرات الاتجاهات المرشحة بتوليد نصوص كاملة، كل ذلك يتطلب موارد حوسبة كبيرة. وهنا تظهر القيمة الحقيقية لـ TPU.
لماذا تناسب TPU هذا النوع من التجارب
لوحدات TPU عدة خصائص تجعلها مثالية لتجارب قابلية التفسير. أولاً، تستخدم مصفوفات انقباضية (systolic arrays) صُممت خصيصاً لعمليات ضرب المصفوفات التي تشكّل العمود الفقري للتمرير الأمامي في الشبكات العصبية. ثانياً، تتميز بذاكرة عالية النطاق (HBM) تتيح تحميل النموذج كاملاً وتخزين التفعيلات الوسيطة بكفاءة. ثالثاً، الدعم الأصلي لـ bfloat16 ميزة كبيرة، لأنه يحافظ على المدى الديناميكي للأرقام مع تقليل استهلاك الذاكرة إلى النصف.
نصيحة عملية عند العمل على TPU، استخدم xm.mark_step() بحكمة. فاستدعاؤه كثيراً يمنع تجميع رسم XLA بكفاءة، واستدعاؤه نادراً قد يسبب تراكماً في الذاكرة. والقاعدة العملية: زامن كل 5 إلى 10 دفعات.
تحسينات الأداء
يتضمن الكود المرافق عدة تحسينات خاصة بـ TPU. فحلقة الاستدلال تُجمَّع كرسم XLA واحد، ما يقلل تكلفة التواصل بين المضيف والجهاز. ويُضبط حجم الدفعة على مضاعفات 8 للاستفادة القصوى من عرض النطاق في وحدات TPU v3. كما تُنقل التفعيلات المستخرجة مباشرة إلى المعالج المركزي (.cpu()) لتجنب استنفاد ذاكرة TPU أثناء مرحلة الاستخراج.
# Extracting activations with TPU optimizations
for batch_idx in range(n_batches):
    with torch.no_grad():
        _ = model(**inputs)

    # Periodic sync — not every batch
    if TPU_AVAILABLE and (batch_idx + 1) % 10 == 0:
        xm.mark_step()

# Move activations to CPU immediately to save TPU memory
    for layer_idx in range(n_layers):
        last_acts = activation_cache[layer_idx]
        layer_activations[layer_idx].append(last_acts.cpu())
مقارنة TPU وGPU لتجارب قابلية التفسير
يواجه الباحثون في قابلية التفسير الآلي خياراً مهماً عند اختيار العتاد. فلكل من TPU وGPU مزايا وعيوب يجب فهمها في سياق هذا النوع تحديداً من التجارب. وفيما يلي مقارنة شاملة مبنية على التجربة العملية والمقاييس المتاحة.
| المعيار | TPU (v3/v4/v5) | GPU (A100/H100) |
|---|---|---|
| بنية الحوسبة | مصفوفات انقباضية متخصصة في عمليات المصفوفات | أنوية CUDA متعددة الاستخدامات مع Tensor Cores |
| أداء الحوسبة الخام | TPU v4: حتى 275 TFLOPS، أعلى إنتاجية لعمليات المصفوفات | A100: حتى 312 TFLOPS (مع التناثر)؛ H100: حتى 989 TFLOPS |
| دعم bfloat16 | أصلي ومحسّن، مثالي للاستدلال والتدريب | مدعوم في Ampere وما بعدها، لكن float16 أكثر شيوعاً عملياً |
| الذاكرة (HBM) | TPU v4: 32 GB، وv5e: 16 GB، تكفي لنماذج من 1B إلى 7B | A100: 40/80 GB، وH100: 80 GB، أكبر وأكثر مرونة |
| التكلفة بالساعة (سحابياً) | نحو 1.35 إلى 3.22 دولار/ساعة (v3-8)، تكلفة أقل لكل FLOP | نحو 3.67 إلى 12 دولاراً/ساعة (A100/H100)، أعلى لكنها متاحة على نطاق أوسع |
| المنظومة البرمجية | JAX أصلياً، وPyTorch عبر XLA، منحنى تعلم أصعب | CUDA ناضجة وPyTorch أصلياً، دعم واسع وأدوات وفيرة |
| التوفر | Google Cloud فقط، إضافة إلى Kaggle وColab (مجاناً بحدود) | متاحة لدى كل مزودي السحابة وللشراء والتشغيل المحلي |
| ملاءمتها لقابلية التفسير | ممتازة لاستخراج التفعيلات بكميات كبيرة والتمريرات الأمامية المتكررة | ممتازة للتجارب التفاعلية والنماذج الأكبر والأدوات التحليلية |
| سهولة تتبع الأخطاء | أصعب: التنفيذ المؤجل يجعل التتبع أقل وضوحاً | أسهل: وضع التنفيذ الفوري (eager) يسهّل تتبع الأخطاء |
متى تختار كلاً منهما
يعتمد الاختيار الأمثل على طبيعة التجربة. فإذا كنت تجري تجارب استكشافية تفاعلية، مثل فحص تفعيلات بعينها أو اختبار فرضيات مختلفة بسرعة، فإن GPU مع PyTorch في وضع التنفيذ الفوري هو الخيار الأفضل. أما إذا كنت تشغّل خط تجربة كاملاً يعالج مئات أو آلاف التعليمات عبر كل طبقات النموذج (كما في هذا البحث)، فإن TPU تقدم نسبة أفضل بين الأداء والتكلفة بفضل تحسينها لعمليات المصفوفات المتكررة.
والنهج الهجين هو الأمثل عملياً: استخدم GPU للتطوير وتتبع الأخطاء والتجارب السريعة، ثم انتقل إلى TPU لتشغيل خط التجربة كاملاً على نطاق واسع. والكود المرافق مصمم لدعم هذا النمط، فهو يكتشف توفر TPU تلقائياً، وينتقل بسلاسة إلى GPU أو CPU عند عدم توفرها.
النتائج المتوقعة وتحليلها
بناءً على نتائج البحث الأصلي على Gemma 2B-IT ونماذج أخرى، نتوقع أن تُظهر تجاربنا على Gemma 3-1B-IT النمط التالي: انخفاضاً حاداً في نسبة الرفض عند إزالة اتجاه الرفض (من نحو 90% إلى أقل من 10%)، وارتفاعاً واضحاً في نسبة الرفض على التعليمات غير الضارة عند حقن الاتجاه (من نحو 0% إلى أكثر من 70%). ونتوقع أيضاً أن يكون الأثر على خسارة الإنتروبيا المتقاطعة محدوداً، ما يعني أن إزالة اتجاه الرفض لا تضر كثيراً بالقدرات اللغوية العامة.
أسئلة بحثية مفتوحة
يطرح هذا الامتداد عدة أسئلة تستحق الاستكشاف. هل يؤثر التناوب بين الانتباه المحلي والشامل في Gemma 3 على موضع ظهور اتجاه الرفض؟ ففي النماذج السابقة، ظهر الاتجاه بأقوى صوره في الطبقات الوسطى إلى المتأخرة. لكن مع البنية الهجينة، قد نجد أن طبقات الانتباه الشامل (التي تظهر كل 6 طبقات) تلعب دوراً أكبر في ترميز قرار الرفض.
وسؤال مهم آخر: هل أثّر تقطير المعرفة من نموذج أكبر (المستخدم في تدريب Gemma 3) في “وضوح” اتجاه الرفض؟ ربما أنتج التقطير تمثيلاً أكثر توزعاً لسلوك الرفض، فيقل أثر الاتجاه الواحد. أو ربما العكس هو الصحيح، فيكون التقطير قد ركّز سلوك الرفض في اتجاه واحد أكثر تميزاً.
ملاحظة أخلاقية يهدف هذا البحث إلى فهم آليات الأمان في النماذج اللغوية وتحسينها. وإزالة اتجاه الرفض تنتج نموذجاً غير آمن لا يجوز نشره أو استخدامه في الإنتاج. والغرض بحثي بحت، لتطوير آليات أمان أقوى وأعمق.
الخلاصة والخطوات التالية
استكشاف اتجاه الرفض في Gemma 3 على TPU امتداد طبيعي للبحث الأصلي الرائد. فالجمع بين بنية جديدة (Gemma 3) وعتاد متخصص (TPU) يتيح لنا اختبار عمومية النتائج الأصلية مع الاستفادة من كفاءة حوسبة أعلى. والكود المرافق جاهز للتشغيل على أي بيئة TPU متاحة، ومنها Google Colab (مع TPU مجانية) وأجهزة Google Cloud TPU الافتراضية.
وللباحثين الراغبين في التعمق أكثر، نوصي بتجربة الأحجام الأكبر من عائلة Gemma 3 (4B و12B و27B) لدراسة كيف يتغير اتجاه الرفض مع حجم النموذج. ومن المفيد أيضاً مقارنة اتجاه الرفض في Gemma 3 بنماذج حديثة أخرى مثل Llama 3.2 وQwen 2.5، لمعرفة ما إذا كانت تقنيات التدريب الحديثة قد غيّرت طبيعة هذا الاتجاه.
هذه نسخة معدّلة ومحدّثة من المستودع:
https://github.com/Ruqyai/refusal_direction/blob/main/Gemma%203-1B-IT%20on%20TPU.md
مصادر: الورقة الأصلية (arXiv) · الكود الأصلي (GitHub) · تدوينة LessWrong · Gemma 3-1B-IT على HuggingFace
بحث تطبيقي يبني على Arditi وآخرين، 2024. الكود مرخص بموجب Apache 2.0. Gemma 3 نموذج من Google، وTPU علامة تجارية لشركة Google.
شكراً لـ Google Cloud
قدّمت Google Cloud أرصدة سحابية لهذا المشروع. #TPUSprint
النسخة الإنجليزية منشورة أيضاً على Medium.