7 أسباب للانتقال إلى وحدات TPU
تم النشر:
الشريحة التي صُممت من الصفر للذكاء الاصطناعي، ولماذا قد تكون خطوتك القادمة
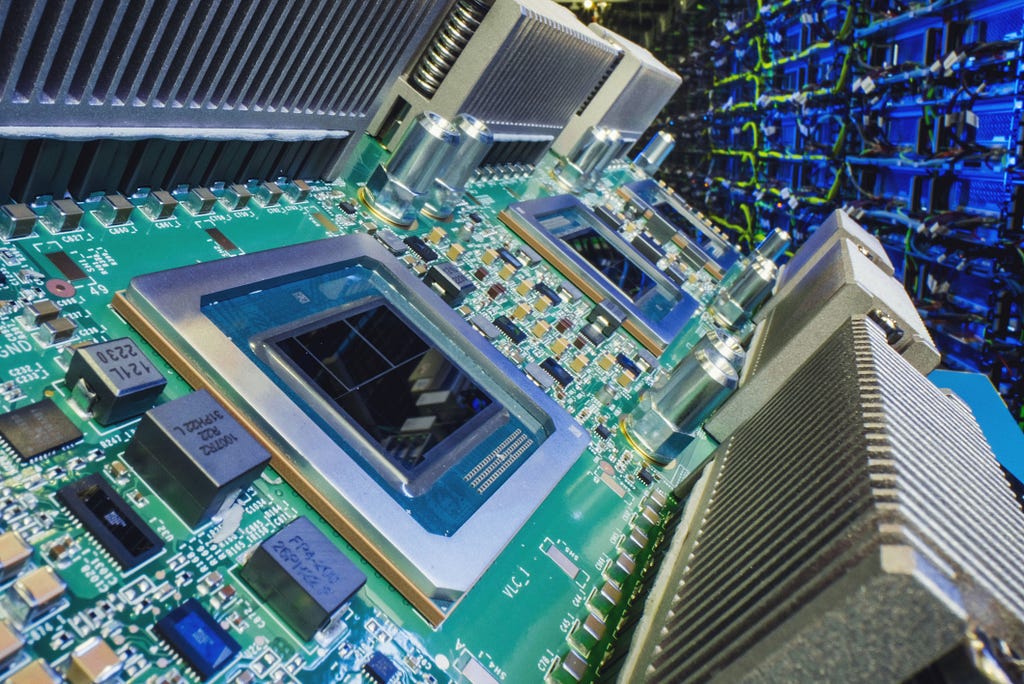
مصدر الصورة: مدونة Google Developers
في كل مرة تسأل فيها روبوت محادثة، أو تشاهد هاتفك يترجم لافتة في الشارع لحظياً، تجري في مكان ما كمية هائلة من العمليات الحسابية. ولأن الخوارزميات لا تعمل بالسحر بل على السيليكون، يصبح السؤال الحقيقي: على أي شريحة تشغّل نماذجك؟ لسنوات طويلة كان الجواب المعتاد هو وحدة معالجة الرسوميات (GPU). لكن هناك بديلاً صُمم خصيصاً لهذه المهمة: وحدة معالجة الموترات (Tensor Processing Unit)، أو TPU.
إليك 7 أسباب تجعل هذا الانتقال يستحق التفكير الجاد.
1. صُممت لمهمة واحدة فقط
المعالج المركزي (CPU) متعدد المواهب وبارع في كل شيء تقريباً. ووحدة معالجة الرسوميات (GPU) متخصصة مرنة اكتشفت براعتها في الذكاء الاصطناعي بالصدفة تقريباً. أما TPU فهي ما يسميه المهندسون ASIC: شريحة بُنيت من الأساس لتؤدي مجموعة ضيقة من المهام بإتقان استثنائي. احذف من الشريحة كل ما لا تحتاجه، وسيصبح ما يتبقى أسرع وأرخص بكثير في مهمته الوحيدة: ضرب مصفوفات ضخمة من الأرقام وجمع النتائج، وهذا هو جوهر عمل كل شبكة عصبية.
2. سرعة كبيرة وكفاءة أعلى في استهلاك الطاقة
في قلب TPU شبكة كثيفة من وحدات الضرب والجمع، كل وحدة متصلة مباشرة بجاراتها (يسميها المهندسون المصفوفة الانقباضية أو systolic array). تتدفق الأرقام عبرها كما يتدفق الماء عبر سلسلة من الأهوسة، دون أن تعود إلى الذاكرة باستمرار. والمكسب ليس السرعة وحدها، بل الكفاءة أيضاً: يقدّم أحدث جيل Ironwood نحو ضعف الأداء لكل واط مقارنة بالجيل السابق (Trillium)، وهو أكفأ في استهلاك الطاقة بنحو 30 ضعفاً من أول TPU سحابية أطلقتها Google. وأقل طاقة يعني تكلفة أقل لكل عملية تدريب ولكل طلب استدلال.
3. حسابات “دقيقة بما يكفي” ترفع الإنتاجية
تهتم الحواسيب العادية بالدقة بشكل مبالغ فيه، بخانات عشرية كثيرة. أما الشبكات العصبية فمتسامحة بشكل مدهش، ولا تحتاج إلى هذه الدقة لتعطي إجابات ممتازة. لذلك تستخدم TPU صيغ أرقام مضغوطة مثل bfloat16 (وأضاف Ironwood دعماً مدمجاً لصيغة أصغر هي FP8). حسابات أقل دقة بقليل، لكنها تعمل أسرع بكثير وتستهلك ذاكرة أقل بكثير. وهذه مقايضة رائعة للذكاء الاصطناعي، تستخرج إنتاجية أكبر من الشريحة نفسها.
4. قابلية توسع شبه غير محدودة عبر الـ Pods
TPU الواحدة قوية، لكن قوتها الحقيقية في العمل الجماعي. تربط Google آلاف الشرائح في وحدات تسمى pods تعمل كأنها آلة واحدة عملاقة. ويصل superpod من Ironwood إلى 9,216 شريحة تتشارك أكثر من 1.77 بيتابايت من الذاكرة عالية النطاق. والأفضل من ذلك أن أطراً مثل JAX توزّع النموذج الواحد على آلاف الشرائح تلقائياً، فتنتقل من شريحة واحدة إلى superpod كامل بالكود نفسه تقريباً.
5. مجرّبة في الإنتاج على أكبر النماذج في العالم
ليست TPU تجربة مخبرية. فهي تشغّل خدمات تستخدمها كل يوم: بحث Google وGoogle Translate وGoogle Photos وGoogle Maps. ونموذج Google الرائد Gemini يُدرَّب ويُشغَّل عليها. والأهم من ذلك أن مختبرات الذكاء الاصطناعي الرائدة، ومنها Anthropic صانعة Claude، تدرّب نماذجها وتشغّلها على TPU، وتخطط Anthropic للوصول إلى نحو مليون وحدة TPU. وإذا كانت الشريحة قادرة على تشغيل أكبر النماذج على وجه الأرض، فهي على الأرجح قادرة على تشغيل نموذجك.
6. أداء أفضل مقابل كل دولار
في أحمال الذكاء الاصطناعي الكبيرة، تقدّم TPU نسبة ممتازة بين الأداء والسعر: يحسّن جيل Trillium الأداء لكل دولار بما بين 2.1 و2.5 ضعف مقارنة بجيل v5. كما أن فلسفة “ما تدرّب عليه هو ما تشغّل عليه“، أي استخدام الشريحة نفسها والدقة نفسها للتدريب والاستدلال، تخفّض التكلفة والتعقيد. لذلك لا عجب أن كثيراً من المحللين يضعون TPU اليوم في مقدمة سباق الأداء مقابل السعر لأنظمة الذكاء الاصطناعي على نطاق الإنتاج.
7. تستطيع البدء اليوم مجاناً
وأجمل ما في الأمر أنك لا تحتاج إلى شراء أي جهاز، ولا حتى إلى حساب على Google Cloud، لتبدأ. يوفر كل من Google Colab وKaggle وصولاً مجانياً إلى وحدات TPU حقيقية، ويمكنك استئجارها على Google Cloud عندما تكبر أحمال عملك. بلا أجهزة، وتبدأ خلال دقائق.
ملاحظة صريحة قبل أن تقرر
ليست TPU الأداة المناسبة لكل مهمة. تبقى وحدات GPU أكثر مرونة، ويدعمها نظام برمجي أوسع، وهي الخيار الأفضل للأبحاث المتنوعة والتجارب السريعة وللأجهزة التي تشتريها وتملكها. والقاعدة العامة: اختر الأداة التي تناسب نوع العمل. لكن إذا كان هدفك تدريب نماذج ذكاء اصطناعي كبيرة أو تشغيلها على نطاق واسع، بكفاءة في التكلفة والطاقة معاً، فإن TPU تستحق مكاناً جاداً في نقاشك.
كيف تبدأ
افتح دفتر Colab مجانياً، وغيّر المسرّع إلى TPU، وابدأ التجربة:
🔗 ابدأ استكشاف TPU على Google Colab
الخطوات بسيطة: من القائمة اختر Runtime ← Change runtime type ← TPU، ثم احفظ. الآن يعمل أي كود JAX تشغّله على TPU حقيقية. ابدأ بعملية ضرب مصفوفات بسيطة، ثم تدرّج حتى تدرّب نموذجاً صغيراً، ولاحظ الفرق بنفسك.
أعجبك المقال؟ هذا الأول في سلسلة قصيرة عن العتاد الذي يقف خلف الذكاء الاصطناعي الحديث. تابعني لقراءة الشرحين القادمين: “كيف تعمل وحدات GPU” و”كيف تُدرَّب نماذج الذكاء الاصطناعي فعلاً”.
قراءات إضافية
- مدونة Google Cloud عن Ironwood (الجيل السابع من TPU): https://blog.google/products/google-cloud/ironwood-tpu-age-of-inference/
- توثيق TPU في Kaggle: https://www.kaggle.com/docs/tpu
النسخة الإنجليزية منشورة أيضاً على Medium.